Da “funziona in locale” a “l'ha scritto Claude” è stato un attimo
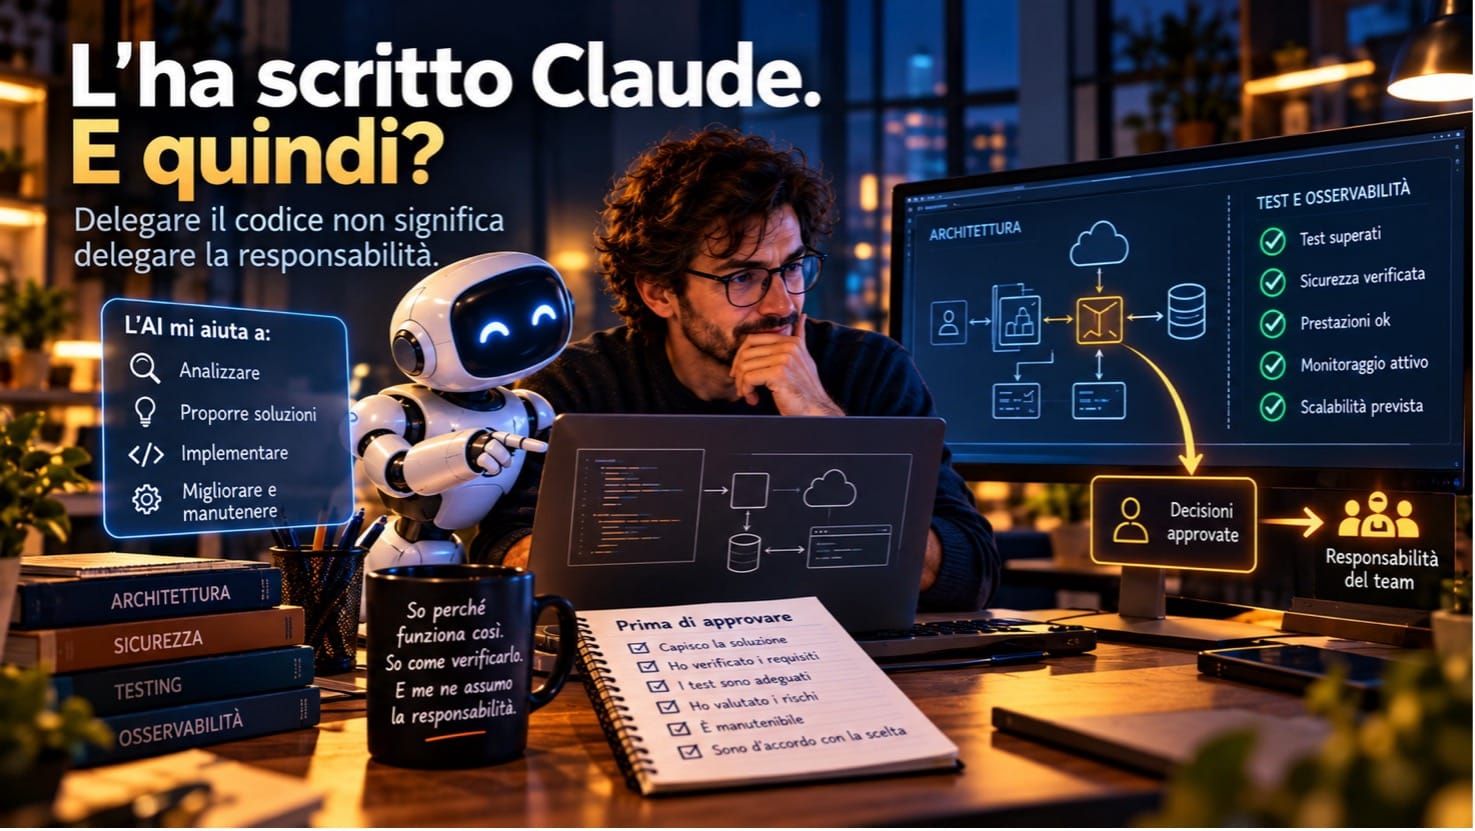
L'intelligenza artificiale sta cambiando il modo in cui sviluppiamo software. Ma mentre impariamo a produrre codice sempre più velocemente, rischiamo di dimenticare una competenza fondamentale: comprenderlo e assumercene la responsabilità.
Una nuova risposta a un vecchio problema
Per anni, nel mondo dello sviluppo software, abbiamo ironizzato su una delle frasi più ricorrenti della nostra professione:
«Sul mio computer funziona.»
Era diventata quasi un simbolo. Una risposta che tutti, prima o poi, abbiamo dato o ricevuto. Dietro quella frase si nascondevano spesso problemi di configurazione, dipendenze, ambienti differenti o semplicemente una comprensione incompleta di ciò che avevamo sviluppato.
Oggi, però, quella frase rischia di essere sostituita da un'altra:
«L'ha scritto Claude.»
O ChatGPT, Cursor, Copilot. Il nome dello strumento conta relativamente.
Il punto è che, sempre più spesso, la risposta alla domanda «Perché hai implementato questa soluzione in questo modo?» rischia di diventare il nome dell'intelligenza artificiale che ha generato il codice.
E questa volta il problema è più profondo.
Perché se prima potevamo non comprendere completamente il comportamento di un'applicazione che avevamo comunque scritto, oggi possiamo ritrovarci a non comprendere un'applicazione che non abbiamo nemmeno progettato.
Eppure funziona.
Almeno fino a quando non smette di farlo.
Non tutti gli sviluppatori stanno vivendo la stessa rivoluzione
Credo che uno degli errori più comuni nel dibattito sull'AI applicata allo sviluppo software sia considerare gli sviluppatori come una categoria omogenea.
Non lo siamo mai stati.
Abbiamo competenze differenti, esperienze differenti e, soprattutto, un rapporto diverso con il nostro lavoro.
L'arrivo dell'intelligenza artificiale non ha eliminato queste differenze. In qualche modo, le sta amplificando.
1. Lo sviluppatore curioso: l'AI come acceleratore di conoscenza
È probabilmente il profilo che trovo più interessante.
È quello sviluppatore che, davanti a una tecnologia che non conosce, non si limita a chiedere all'AI di realizzare qualcosa.
Vuole capire.
Le chiede di spiegare un pattern architetturale, confrontare due implementazioni, approfondire il funzionamento di un framework, individuare i limiti di una soluzione.
Magari genera del codice, ma poi lo analizza, lo modifica, ne mette in discussione le scelte.
Utilizza l'AI per affrontare problemi che prima avrebbero richiesto ore di documentazione, prove ed errori.
Non sempre accetta la prima risposta. Anzi, spesso è proprio da quella risposta che nasce una nuova domanda.
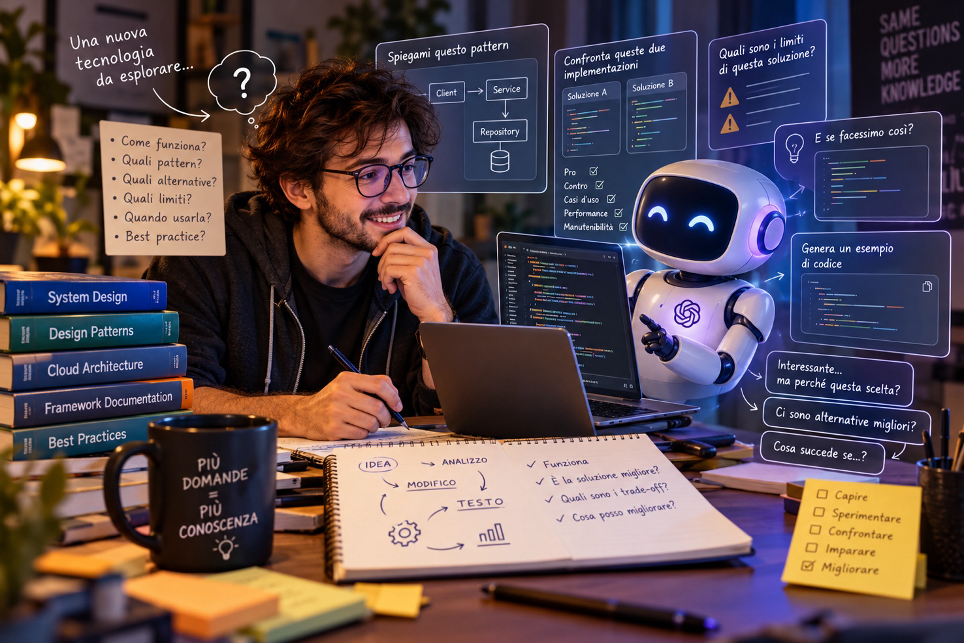
L'AI, in questo caso, non riduce la curiosità. La alimenta.
E credo che questo atteggiamento possa essere presente tanto in uno sviluppatore junior quanto in un professionista con vent'anni di esperienza.
La differenza non è quanti anni si lavora nel settore, ma quanto si è ancora interessati a comprenderlo.
2. Lo sviluppatore consapevole: delegare senza perdere il controllo
C'è poi chi ha già maturato una solida esperienza nella progettazione e nello sviluppo software.
Conosce il significato delle scelte architetturali, ha affrontato problemi di scalabilità, manutenzione, sicurezza e integrazione.
Per questo non ha necessariamente bisogno di scrivere personalmente ogni riga di codice.
Può utilizzare un coding agent per implementare intere funzionalità, generare test, effettuare refactoring o automatizzare attività ripetitive.
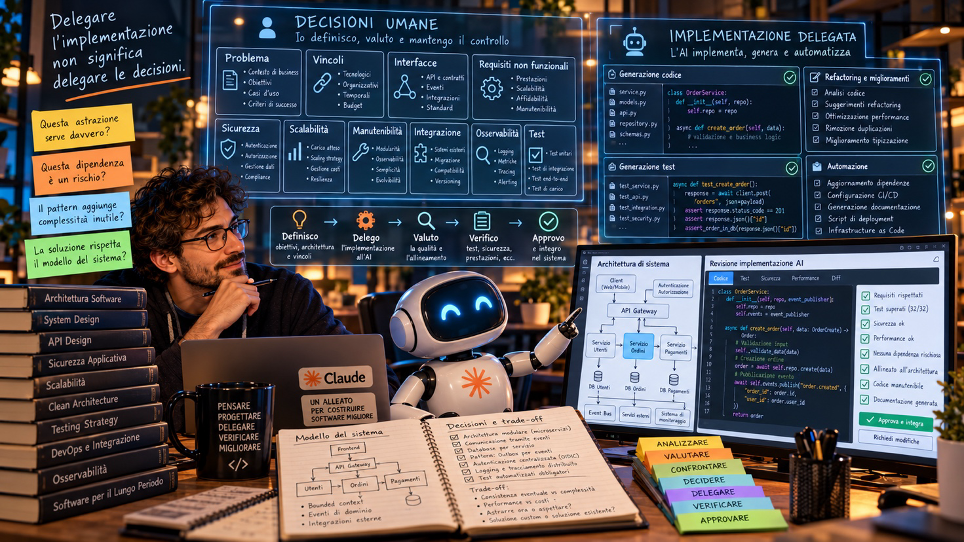
Ma mantiene una distinzione fondamentale:
Delegare l'implementazione non significa delegare le decisioni.
Prima di generare codice, definisce il problema. Identifica vincoli, responsabilità, interfacce e requisiti non funzionali.
Quando l'AI propone una soluzione, ha gli strumenti per valutarla.
Sa riconoscere quando un'astrazione è superflua, quando un pattern introduce complessità inutile o quando una dipendenza potrebbe diventare un problema.
Non significa che debba leggere personalmente ogni singola riga prodotta dall'AI.
Significa che deve possedere un modello mentale sufficientemente chiaro del sistema e disporre delle verifiche necessarie per dimostrare che la soluzione rispetta quel modello.
L'AI diventa un moltiplicatore della sua capacità produttiva.
E, soprattutto, non gli sottrae la responsabilità delle scelte.
3. Lo sviluppatore disilluso: quando l'AI diventa una via d'uscita
Questa è forse la categoria più delicata da affrontare.
Perché non riguarda necessariamente professionisti privi di competenze.
Anzi.
A volte riguarda sviluppatori con anni di esperienza, persone che hanno attraversato tecnologie, framework, migrazioni, progetti complessi.
Ma che nel tempo hanno progressivamente perso interesse per la professione.
Le motivazioni possono essere molteplici: stanchezza, pressione sulle consegne, contesti organizzativi poco stimolanti, tecnologie che cambiano continuamente, mancanza di riconoscimento.
Poi arriva l'intelligenza artificiale.
Uno strumento capace di scrivere codice, correggere errori, generare test, creare intere funzionalità.
E ciò che inizialmente rappresentava un aiuto può diventare una scorciatoia.
Non serve più approfondire troppo. Non serve conoscere davvero quel framework. Non serve nemmeno comprendere fino in fondo perché una soluzione sia stata implementata in un certo modo.
Basta continuare a chiedere.
Il codice compila? Bene.
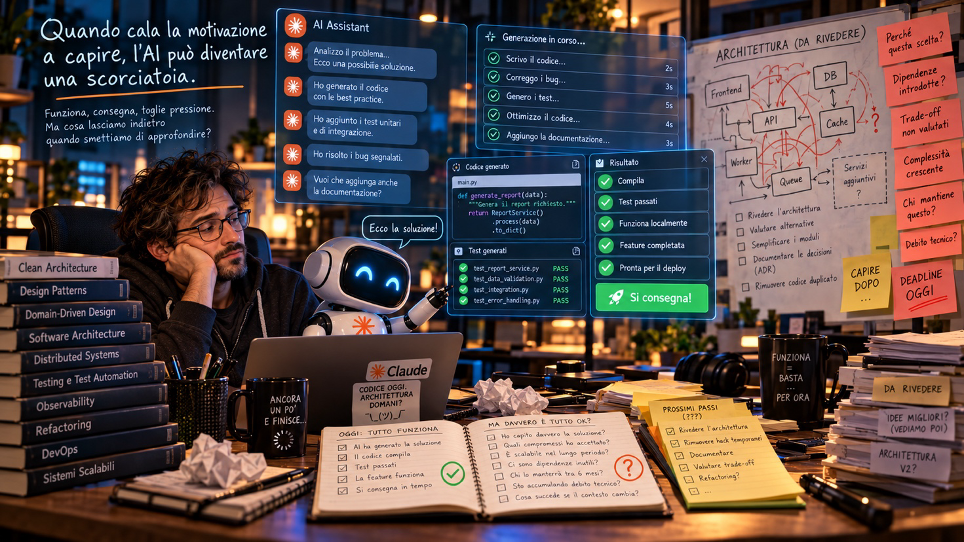
I test passano? Ancora meglio.
La funzionalità sembra funzionare? Si consegna.
Non credo sia corretto giudicare superficialmente queste persone. Spesso il disinteresse è anche il risultato dell'ambiente in cui lavorano.
Ma il rischio tecnico rimane.
Quando viene meno la motivazione a comprendere ciò che produciamo, l'AI può trasformarsi da strumento di produttività in uno strumento di disimpegno cognitivo.
E la cosa più pericolosa è che, almeno inizialmente, i risultati possono sembrare persino migliori.
4. Il delegatore inconsapevole: produrre senza saper valutare
Esiste infine un atteggiamento ancora differente, che può interessare sia professionisti esperti sia persone che si stanno avvicinando allo sviluppo software.
È quello di chi affida all'AI attività che non possiede ancora gli strumenti per valutare.
Qui emerge un problema particolarmente importante per le nuove generazioni di sviluppatori.
Fino a pochi anni fa, per costruire un'applicazione relativamente complessa, era necessario affrontare una serie di difficoltà.
Capire come funzionava un framework. Gestire errori. Leggere documentazione. Comprendere le dipendenze. Confrontarsi con i limiti dell'architettura scelta.
Era un processo talvolta frustrante, ma era anche parte integrante dell'apprendimento.
Oggi è possibile ottenere in poche ore risultati che prima avrebbero richiesto settimane.
È un'opportunità straordinaria.
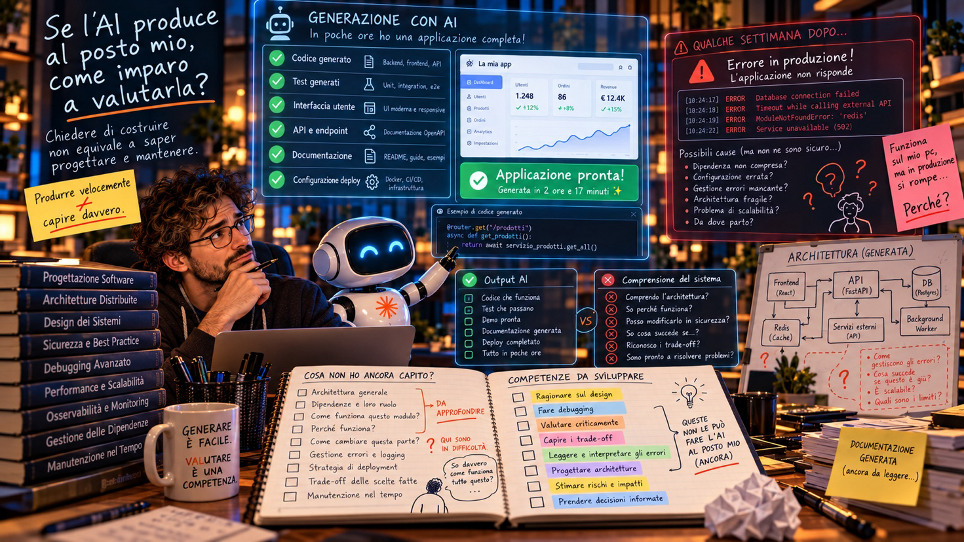
Ma nasconde una domanda.
Se eliminiamo buona parte delle difficoltà attraverso cui si costruisce la competenza, come svilupperemo la capacità di giudicare ciò che l'AI produce?
Non penso che i nuovi sviluppatori debbano necessariamente imparare nello stesso modo in cui abbiamo imparato noi.
Sarebbe una posizione nostalgica e probabilmente sbagliata.
Ma devono comunque sviluppare capacità di ragionamento, debugging, progettazione e valutazione critica.
Perché saper chiedere all'AI di costruire un'applicazione non equivale a saper progettare e mantenere quell'applicazione.
E la differenza emerge quando qualcosa non funziona.
Il vero problema non è chi scrive il codice. È chi se ne assume la responsabilità.
C'è un aspetto che considero centrale e che, a mio avviso, riceve ancora troppo poca attenzione.
Possiamo assumerci la responsabilità tecnica di qualcosa che non abbiamo scritto e che non comprendiamo completamente?
La prima parte della risposta è sì.
Accade da sempre.
Utilizziamo librerie, framework, servizi cloud, database e componenti open source di cui certamente non conosciamo ogni singola riga di codice.
Eppure siamo perfettamente in grado di progettare sistemi affidabili utilizzandoli.
Perché?
Perché disponiamo di contratti, interfacce, documentazione, comportamenti attesi, strumenti di osservabilità e meccanismi di validazione.
Non dobbiamo conoscere ogni dettaglio implementativo.
Dobbiamo conoscere sufficientemente bene i confini del sistema, le sue garanzie e i suoi punti di fallimento.
Con il codice generato dall'AI dovrebbe valere esattamente lo stesso principio.
Il problema nasce quando accettiamo l'implementazione senza definire prima cosa debba garantire.
Quando non sappiamo spiegare perché un componente esiste, quali responsabilità possiede o quali conseguenze potrebbe avere una sua modifica.
In queste condizioni, la responsabilità resta formalmente nostra, ma abbiamo perso gli strumenti per esercitarla.
Ed è una situazione particolarmente pericolosa per chi ricopre ruoli di responsabilità tecnica.
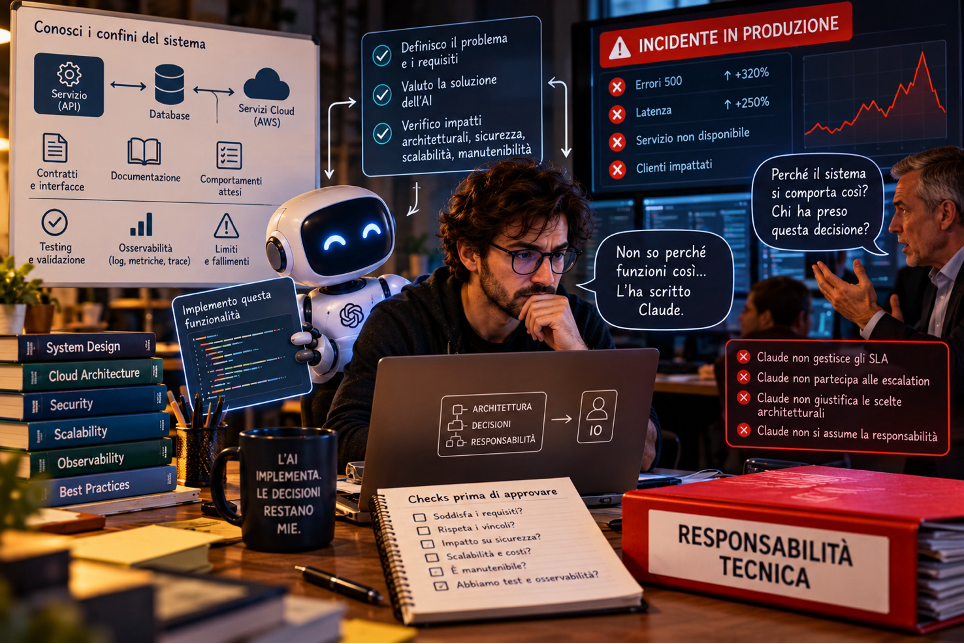
Perché quando un sistema entra in produzione e comincia a manifestare comportamenti anomali, non possiamo rispondere al cliente:
«Non so perché funzioni così. L'ha scritto Claude.»
Claude non partecipa alle escalation.
Non risponde degli SLA.
Non giustifica una scelta architetturale davanti a un cliente.
E soprattutto non si assume la responsabilità delle conseguenze di quella scelta.
Quella rimane nostra.
Il debito tecnico alla velocità dell'intelligenza artificiale
Il debito tecnico non è certamente nato con l'AI.
Abbiamo costruito sistemi difficili da mantenere molto prima che esistessero i coding agent.
La differenza, oggi, è la velocità con cui possiamo generare complessità.
Immaginiamo un progetto che parta da requisiti relativamente semplici.
Chiediamo all'AI di implementare una prima funzionalità.
Poi una seconda.
Poi una terza.
A un certo punto compare un problema. Lo descriviamo all'agente e gli chiediamo di risolverlo.
L'agente modifica alcune funzioni, introduce uno stato aggiuntivo, crea un nuovo livello di astrazione.
Il problema sembra risolto.
Qualche giorno dopo emerge un'anomalia collegata alla modifica precedente.
Nuovo prompt. Nuova soluzione. Nuovo codice.
E così via.
Ogni intervento può essere localmente ragionevole. Ma nessuno sta necessariamente verificando che l'architettura complessiva rimanga coerente.
Con il tempo iniziano a comparire responsabilità duplicate, stati ridondanti, logiche distribuite tra componenti diversi e dipendenze sempre più difficili da ricostruire.
Il sistema continua a funzionare.
Ma diventa progressivamente meno comprensibile.
A quel punto, anche una modifica banale può richiedere interventi in numerosi componenti.
L'AI, che inizialmente aveva accelerato lo sviluppo, diventa indispensabile perfino per riuscire a modificare ciò che essa stessa ha contribuito a costruire.
Ed è qui che intravedo uno dei rischi maggiori.
Non soltanto accumulare debito tecnico, ma accumulare debito di comprensione.
Il debito tecnico riguarda le conseguenze delle scelte progettuali e implementative.
Il debito di comprensione riguarda invece la progressiva perdita, da parte del team, di una rappresentazione affidabile del sistema.
I due fenomeni possono alimentarsi a vicenda.
Più il sistema diventa difficile da capire, più siamo tentati di affidarne le modifiche all'AI.
Più deleghiamo senza controllo, più rischiamo di perdere la comprensione delle nuove modifiche.
Un circolo vizioso che può trasformare anche un progetto relativamente giovane in un sistema estremamente difficile da governare.
Quando il vibe coding smette di essere un esperimento
Il vibe coding ha un valore reale.
Permette di sperimentare idee, realizzare prototipi, validare ipotesi e costruire rapidamente applicazioni che altrimenti non avrebbero mai visto la luce.
Non vedo nulla di sbagliato in questo.
Il problema nasce quando la stessa modalità operativa viene trasferita, senza adattamenti, nello sviluppo di sistemi che devono essere mantenuti, evoluti e gestiti nel tempo.
Un prototipo può permettersi di privilegiare la velocità rispetto alla struttura.
Una piattaforma enterprise no.
Pensiamo a un'applicazione che gestisce processi aziendali, integra sistemi esterni, mantiene stati conversazionali, esegue workflow, interroga basi documentali e prende decisioni in base a informazioni provenienti da fonti differenti.
In un sistema del genere non è sufficiente che ogni singola funzionalità sembri funzionare.
Occorre che l'insieme abbia un comportamento coerente e verificabile.
Chi possiede lo stato? Chi prende le decisioni? Quali componenti possono modificarlo? Come vengono gestite le eccezioni? Quali sono le garanzie sulle informazioni utilizzate? Come possiamo ricostruire il motivo per cui il sistema ha prodotto un determinato risultato?
Sono domande architetturali.
E non possiamo risolverle semplicemente continuando a chiedere a un coding agent di correggere il comportamento osservato.
Un sistema può superare decine di test locali e continuare a essere architetturalmente fragile.
Anzi, talvolta è proprio la continua aggiunta di correzioni locali a renderlo tale.
Non tutto il codice generato dall'AI è vibe coding.
Ma qualsiasi progetto può diventarlo quando smettiamo di prendere decisioni consapevoli e iniziamo a limitarci ad accettare quelle proposte dall'agente.
E se il vero problema fossero le nostre organizzazioni?
Sarebbe però troppo semplice attribuire tutta la responsabilità ai singoli sviluppatori.
C'è un altro elemento da considerare.
Le organizzazioni chiedono sempre più velocità.
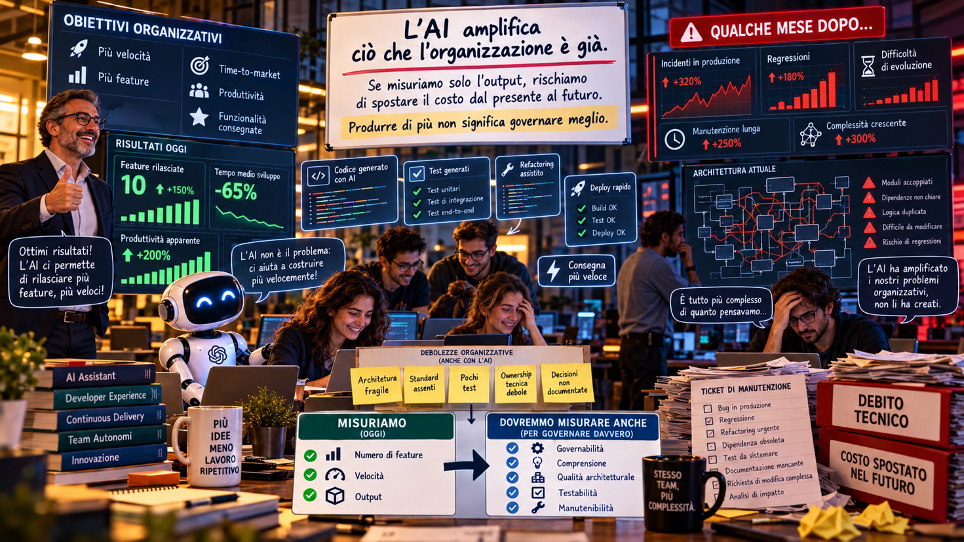
L'intelligenza artificiale viene spesso introdotta con una promessa piuttosto chiara: aumentare la produttività, ridurre i tempi di sviluppo e consegnare più funzionalità.
Sono obiettivi legittimi.
Ma cosa succede quando iniziamo a misurare il valore degli sviluppatori principalmente sulla quantità di codice o di funzionalità prodotte?
Se uno sviluppatore consegna dieci funzionalità invece di tre, può sembrare che la produttività sia aumentata enormemente.
Ma se quelle dieci funzionalità introducono un livello di complessità che il team non è più in grado di governare, quale produttività abbiamo realmente ottenuto?
Stiamo semplicemente spostando il costo dal presente al futuro.
E spesso il futuro arriva sotto forma di incidenti, regressioni, difficoltà di evoluzione e lunghi interventi di manutenzione.
Il problema diventa ancora più evidente quando l'AI viene utilizzata in organizzazioni che già soffrono di carenze architetturali, assenza di standard, scarsa cultura del testing o mancanza di ownership tecnica.
In questi contesti l'AI rischia di amplificare problemi preesistenti.
Non perché generi necessariamente software peggiore.
Ma perché permette di produrne molto di più, prima che qualcuno abbia avuto il tempo di comprenderne le conseguenze.
Non serve meno AI. Serve più ingegneria.
Non credo che la soluzione sia limitare l'utilizzo dell'intelligenza artificiale.
Sarebbe paradossale rinunciare a strumenti tanto potenti proprio mentre stiamo imparando a sfruttarli.
Credo invece che l'AI renda ancora più importante una disciplina che talvolta abbiamo sacrificato in nome della velocità: l'ingegneria del software.
Prima di chiedere a un agente di implementare una funzionalità, dovremmo essere in grado di definirne requisiti, vincoli e criteri di accettazione.
Prima di approvare una modifica, dovremmo comprenderne l'impatto architetturale.
Dovremmo utilizzare test automatizzati, analisi statica, strumenti di osservabilità e verifiche di sicurezza non come formalità, ma come meccanismi per mantenere il controllo su ciò che produciamo.
Anche approcci come lo Spec-Driven Development, pur non essendo una soluzione miracolosa, possono contribuire a separare meglio le responsabilità.
L'essere umano definisce il problema, valuta le alternative, approva il design e stabilisce i vincoli.
L'agente contribuisce ad analizzare, implementare, testare e documentare.
Le decisioni rilevanti rimangono esplicite e verificabili.
Naturalmente non basta scrivere una specifica per ottenere automaticamente un buon progetto.
Ma almeno si inverte una tendenza pericolosa: invece di lasciare che sia il codice generato a determinare progressivamente l'architettura, si cerca di fare in modo che sia un'architettura ragionata a guidare la generazione del codice.
E questo, per me, è il punto fondamentale.
Non dobbiamo necessariamente controllare ogni singola istruzione.
Dobbiamo governare il processo attraverso cui quelle istruzioni diventano un sistema.
Il futuro degli sviluppatori non dipenderà soltanto dalla capacità di usare l'AI
Credo che nei prossimi anni assisteremo a una differenziazione sempre più evidente.
Da una parte ci saranno professionisti capaci di utilizzare l'intelligenza artificiale per ampliare le proprie competenze, accelerare le attività e affrontare problemi di complessità crescente.
Dall'altra ci saranno persone che utilizzeranno gli stessi strumenti per evitare progressivamente di confrontarsi con quella complessità.
All'inizio, osservando soltanto i risultati, potrebbe essere difficile distinguere i due approcci.
Entrambi potrebbero produrre applicazioni funzionanti.
Entrambi potrebbero consegnare velocemente.
Entrambi potrebbero utilizzare gli stessi coding agent.
La differenza emergerà nel tempo.
Quando sarà necessario modificare l'architettura, affrontare un problema di produzione, analizzare un comportamento anomalo o spiegare perché una determinata decisione è stata presa.
In quel momento non conterà soltanto chi è stato capace di generare più codice.
Conterà chi sarà ancora in grado di comprenderlo.
E non penso che questo significhi necessariamente scrivere meno codice con l'AI.
Al contrario, credo che gli sviluppatori più preparati potranno delegare sempre più attività, proprio perché possiederanno le competenze necessarie per definire, verificare e governare il risultato.
Il rischio maggiore non sarà quindi l'automazione in sé.
Sarà confondere la capacità di utilizzare uno strumento con la competenza necessaria per assumersi la responsabilità di ciò che quello strumento produce.
Conclusione: l'ha scritto Claude. E quindi?
Non ho nostalgia per il tempo in cui dovevamo scrivere manualmente centinaia di righe di codice ripetitivo.
Non penso che un bravo sviluppatore debba dimostrare il proprio valore evitando l'intelligenza artificiale.
E non credo nemmeno che l'AI debba essere relegata a semplici attività di completamento del codice.
Può fare molto di più.
Può essere un collaboratore straordinario nell'analisi, nella progettazione, nell'implementazione e nella manutenzione dei sistemi software.
Ma c'è una distinzione che non dovremmo perdere.
Possiamo delegare la scrittura del codice. Possiamo delegare parte dell'analisi. Possiamo persino delegare la proposta di soluzioni architetturali. Non possiamo delegare la responsabilità di averle accettate.
Forse, allora, dovremmo smettere di chiedere soltanto quanto codice riesce a produrre uno sviluppatore con l'AI.
E iniziare a chiederci quanto di quel codice il suo team sia realmente in grado di governare.
Perché, alla fine, non c'è nulla di sbagliato nel dire:
«L'ha scritto Claude.»
Purché siamo ancora in grado di aggiungere:
«Ma so perché funziona così. So come verificarlo. E me ne assumo la responsabilità.»